提示 :此條目的主題不是
部分決定係數 (Coefficient of partial determination)。
在機率論 和統計學 中,偏相關 (:隨機變數 在移除了其他控制變量(Confounding variables)的影響後的相關 程度。
在確定兩個感興趣變量之間的數值關係時,如果存在與這兩個變量都相關的混雜變量 ,直接計算它們的相關係數 可能會產生誤導性結果 (偽相關)。通過計算偏相關係數控制混雜變量,可以避免這種誤導性資訊。這正是多元線性迴歸 中包含其他右側變量的動機;雖然多元迴歸給出了效果量 的不偏 結果,但它並不直接給出一個數值來度量兩個感興趣變量之間關係的強度。
例如,給定關於個人消費、收入和財富的經濟數據,如果希望分析消費與收入之間的關係,而在計算相關係數時未能控制「財富」這一變量,可能會得到誤導性的結果。因為收入可能與財富相關,而財富又與消費相關;直接測量的消費與收入之間的相關性可能會被這些其他相關性所「污染」。使用偏相關可以避免這個問題。
與普通的相關係數一樣,偏相關係數的取值範圍也是從 -1 到 1。
值 -1 表示在控制某些變量後,存在完全的負相關(即一個變量值越高,另一個變量值越低);
值 1 表示完全的正線性關係;
值 0 表示沒有線性關係。 如果隨機變數的聯合分布 是多元常態分布 、其他橢圓分布 、多元超幾何分布、多元負超幾何分布、多項分布或狄利克雷分布,則偏相關與條件相關 一致,但一般情況下兩者並不相同。[ 1]
形式上,給定一組
n
{\displaystyle n}
Z
=
{
Z
1
,
Z
2
,
…
,
Z
n
}
{\displaystyle \mathbf {Z} =\{Z_{1},Z_{2},\dots ,Z_{n}\}}
X
{\displaystyle X}
Y
{\displaystyle Y}
ρ
X
Y
⋅
Z
{\displaystyle \rho _{XY\cdot \mathbf {Z} }}
X
{\displaystyle X}
Z
{\displaystyle \mathbf {Z} }
線性迴歸 的殘差
e
X
{\displaystyle e_{X}}
Y
{\displaystyle Y}
Z
{\displaystyle \mathbf {Z} }
e
Y
{\displaystyle e_{Y}}
相關係數 。
一階偏相關(即
n
=
1
{\displaystyle n=1}
[ 2]
計算樣本偏相關的一種簡單方法是求解兩個相關的線性迴歸 問題,並計算殘差之間的相關性 。
設
X
{\displaystyle X}
Y
{\displaystyle Y}
Z
{\displaystyle \mathbf {Z} }
n
{\displaystyle n}
x
i
,
y
i
,
z
i
{\displaystyle x_{i},y_{i},\mathbf {z} _{i}}
X
,
Y
,
Z
{\displaystyle X,Y,\mathbf {Z} }
聯合分布 中抽取的
N
{\displaystyle N}
獨立同分布 (i.i.d.)觀測值中的第
i
{\displaystyle i}
z
i
{\displaystyle \mathbf {z} _{i}}
求解線性迴歸問題相當於找到
(
n
+
1
)
{\displaystyle (n+1)}
w
X
∗
{\displaystyle \mathbf {w} _{X}^{*}}
w
Y
∗
{\displaystyle \mathbf {w} _{Y}^{*}}
w
X
∗
=
arg
min
w
{
∑
i
=
1
N
(
x
i
−
⟨
w
,
z
i
⟩
)
2
}
{\displaystyle \mathbf {w} _{X}^{*}=\arg \min _{\mathbf {w} }\left\{\sum _{i=1}^{N}(x_{i}-\langle \mathbf {w} ,\mathbf {z} _{i}\rangle )^{2}\right\}}
w
Y
∗
=
arg
min
w
{
∑
i
=
1
N
(
y
i
−
⟨
w
,
z
i
⟩
)
2
}
{\displaystyle \mathbf {w} _{Y}^{*}=\arg \min _{\mathbf {w} }\left\{\sum _{i=1}^{N}(y_{i}-\langle \mathbf {w} ,\mathbf {z} _{i}\rangle )^{2}\right\}}
其中
N
{\displaystyle N}
⟨
w
,
z
i
⟩
{\displaystyle \langle \mathbf {w} ,\mathbf {z} _{i}\rangle }
w
{\displaystyle \mathbf {w} }
z
i
{\displaystyle \mathbf {z} _{i}}
純量積 。
殘差為:
e
X
,
i
=
x
i
−
⟨
w
X
∗
,
z
i
⟩
{\displaystyle e_{X,i}=x_{i}-\langle \mathbf {w} _{X}^{*},\mathbf {z} _{i}\rangle }
e
Y
,
i
=
y
i
−
⟨
w
Y
∗
,
z
i
⟩
{\displaystyle e_{Y,i}=y_{i}-\langle \mathbf {w} _{Y}^{*},\mathbf {z} _{i}\rangle }
樣本偏相關係數即為這些新生成的殘差 值之間的樣本相關係數 :
ρ
^
X
Y
⋅
Z
=
N
∑
i
=
1
N
e
X
,
i
e
Y
,
i
−
∑
i
=
1
N
e
X
,
i
∑
i
=
1
N
e
Y
,
i
N
∑
i
=
1
N
e
X
,
i
2
−
(
∑
i
=
1
N
e
X
,
i
)
2
N
∑
i
=
1
N
e
Y
,
i
2
−
(
∑
i
=
1
N
e
Y
,
i
)
2
=
N
∑
i
=
1
N
e
X
,
i
e
Y
,
i
N
∑
i
=
1
N
e
X
,
i
2
N
∑
i
=
1
N
e
Y
,
i
2
.
{\displaystyle {\begin{aligned}{\hat {\rho }}_{XY\cdot \mathbf {Z} }&={\frac {N\sum _{i=1}^{N}e_{X,i}e_{Y,i}-\sum _{i=1}^{N}e_{X,i}\sum _{i=1}^{N}e_{Y,i}}{{\sqrt {N\sum _{i=1}^{N}e_{X,i}^{2}-\left(\sum _{i=1}^{N}e_{X,i}\right)^{2}}}~{\sqrt {N\sum _{i=1}^{N}e_{Y,i}^{2}-\left(\sum _{i=1}^{N}e_{Y,i}\right)^{2}}}}}\\&={\frac {N\sum _{i=1}^{N}e_{X,i}e_{Y,i}}{{\sqrt {N\sum _{i=1}^{N}e_{X,i}^{2}}}~{\sqrt {N\sum _{i=1}^{N}e_{Y,i}^{2}}}}}.\end{aligned}}}
在第一個表達式中,減號後的三項都等於 0,因為它們包含普通最小平方法 迴歸的殘差和(必定為 0)。
考慮三個變量
X
,
Y
,
Z
{\displaystyle X,Y,Z}
X
Y
Z
2
1
0
4
2
0
15
3
1
20
4
1
計算變量
X
{\displaystyle X}
Y
{\displaystyle Y}
皮爾森相關係數 約為 0.970;而使用上述公式計算
X
{\displaystyle X}
Y
{\displaystyle Y}
Z
{\displaystyle Z}
R語言 進行的計算:
> x <- c ( 2 , 4 , 15 , 20 )
> y <- c ( 1 , 2 , 3 , 4 )
> z <- c ( 0 , 0 , 1 , 1 )
# 将 x 对 z 进行回归并计算残差
> res_x <- lm ( x ~ z ) $ residuals
# 将 y 对 z 进行回归并计算残差
> res_y <- lm ( y ~ z ) $ residuals
# 计算残差的相关性
> cor ( res_x , res_y )
# [1] 0.919145
# 显示这与 x 和 y 之间的直接相关性不同
> cor ( x , y )
# [1] 0.9695016
求解線性迴歸問題在計算上可能非常昂貴。實際上,
n
{\displaystyle n}
|
Z
|
=
n
{\displaystyle |\mathbf {Z} |=n}
(
n
−
1
)
{\displaystyle (n-1)}
ρ
X
Y
⋅
∅
{\displaystyle \rho _{XY\cdot \varnothing }}
相關係數
ρ
X
Y
{\displaystyle \rho _{XY}}
對於任意
Z
0
∈
Z
{\displaystyle Z_{0}\in \mathbf {Z} }
[ 3]
ρ
X
Y
⋅
Z
=
ρ
X
Y
⋅
Z
∖
{
Z
0
}
−
ρ
X
Z
0
⋅
Z
∖
{
Z
0
}
ρ
Z
0
Y
⋅
Z
∖
{
Z
0
}
1
−
ρ
X
Z
0
⋅
Z
∖
{
Z
0
}
2
1
−
ρ
Z
0
Y
⋅
Z
∖
{
Z
0
}
2
{\displaystyle \rho _{XY\cdot \mathbf {Z} }={\frac {\rho _{XY\cdot \mathbf {Z} \setminus \{Z_{0}\}}-\rho _{XZ_{0}\cdot \mathbf {Z} \setminus \{Z_{0}\}}\rho _{Z_{0}Y\cdot \mathbf {Z} \setminus \{Z_{0}\}}}{{\sqrt {1-\rho _{XZ_{0}\cdot \mathbf {Z} \setminus \{Z_{0}\}}^{2}}}{\sqrt {1-\rho _{Z_{0}Y\cdot \mathbf {Z} \setminus \{Z_{0}\}}^{2}}}}}}
如果單純地將此計算實現為遞迴算法 ,會產生指數級的時間複雜度 。然而,由於該計算具有重疊子問題 性質,使用動態規劃 或簡單地緩存遞迴調用的結果可以產生
O
(
n
3
)
{\displaystyle {\mathcal {O}}(n^{3})}
特別地,當
Z
{\displaystyle Z}
ρ
X
Y
⋅
Z
=
ρ
X
Y
−
ρ
X
Z
ρ
Z
Y
1
−
ρ
X
Z
2
1
−
ρ
Z
Y
2
{\displaystyle \rho _{XY\cdot Z}={\frac {\rho _{XY}-\rho _{XZ}\rho _{ZY}}{{\sqrt {1-\rho _{XZ}^{2}}}{\sqrt {1-\rho _{ZY}^{2}}}}}}
偏相關也可以用聯合精度矩陣 (Precision matrix)來表示。考慮一組隨機變數
V
=
{
X
1
,
…
,
X
n
}
{\displaystyle \mathbf {V} =\{X_{1},\dots ,X_{n}\}}
V
∖
{
X
i
,
X
j
}
{\displaystyle \mathbf {V} \setminus \{X_{i},X_{j}\}}
X
i
{\displaystyle X_{i}}
X
j
{\displaystyle X_{j}}
假設(聯合/完整)共變異數矩陣
Σ
=
(
σ
i
j
)
{\displaystyle \Sigma =(\sigma _{ij})}
正定矩陣 ,因此是可逆矩陣 。定義精度矩陣為
Ω
=
(
p
i
j
)
=
Σ
−
1
{\displaystyle \Omega =(p_{ij})=\Sigma ^{-1}}
ρ
X
i
X
j
⋅
V
∖
{
X
i
,
X
j
}
=
−
p
i
j
p
i
i
p
j
j
{\displaystyle \rho _{X_{i}X_{j}\cdot \mathbf {V} \setminus \{X_{i},X_{j}\}}=-{\frac {p_{ij}}{\sqrt {p_{ii}p_{jj}}}}}
1
計算此式需要求共變異數矩陣
Σ
{\displaystyle \Sigma }
Σ
−
1
{\displaystyle \Sigma ^{-1}}
O
(
n
3
)
{\displaystyle {\mathcal {O}}(n^{3})}
V
{\displaystyle \mathbf {V} }
偏相關的幾何解釋(以
N
=
3
{\displaystyle N=3}
設三個變量
X
,
Y
,
Z
{\displaystyle X,Y,Z}
Z
{\displaystyle Z}
n
{\displaystyle n}
V
{\displaystyle \mathbf {V} }
v
i
,
1
≤
i
≤
N
{\displaystyle \mathbf {v} _{i},1\leq i\leq N}
V
{\displaystyle \mathbf {V} }
N
{\displaystyle N}
n
{\displaystyle n}
獨立同分布 觀測值。
考慮由觀測值形成的
N
{\displaystyle N}
x
{\displaystyle \mathbf {x} }
y
{\displaystyle \mathbf {y} }
z
{\displaystyle \mathbf {z} }
X
{\displaystyle X}
Z
{\displaystyle \mathbf {Z} }
e
X
,
i
{\displaystyle e_{X,i}}
N
{\displaystyle N}
e
X
{\displaystyle \mathbf {e} _{X}}
r
X
{\displaystyle \mathbf {r} _{X}}
Z
{\displaystyle \mathbf {Z} }
z
{\displaystyle \mathbf {z} }
純量積 為零。這意味著殘差向量位於垂直於
z
{\displaystyle \mathbf {z} }
(
N
−
1
)
{\displaystyle (N-1)}
超平面
S
z
{\displaystyle S_{\mathbf {z} }}
同理也適用於
Y
{\displaystyle Y}
e
Y
{\displaystyle \mathbf {e} _{Y}}
x
{\displaystyle \mathbf {x} }
y
{\displaystyle \mathbf {y} }
z
{\displaystyle \mathbf {z} }
投影
e
X
{\displaystyle \mathbf {e} _{X}}
e
Y
{\displaystyle \mathbf {e} _{Y}}
ϕ
{\displaystyle \phi }
餘弦 。[ 4] : ch. 7
假設所有涉及的變量都是多元高斯分布 的,偏相關
ρ
X
Y
⋅
Z
{\displaystyle \rho _{XY\cdot \mathbf {Z} }}
X
{\displaystyle X}
Z
{\displaystyle \mathbf {Z} }
Y
{\displaystyle Y}
條件獨立 。[ 1]
為了檢定 樣本偏相關
ρ
^
X
Y
⋅
Z
{\displaystyle {\hat {\rho }}_{XY\cdot \mathbf {Z} }}
費雪轉換 (Fisher's z-transform):
z
(
ρ
^
X
Y
⋅
Z
)
=
1
2
ln
(
1
+
ρ
^
X
Y
⋅
Z
1
−
ρ
^
X
Y
⋅
Z
)
{\displaystyle z({\hat {\rho }}_{XY\cdot \mathbf {Z} })={\frac {1}{2}}\ln \left({\frac {1+{\hat {\rho }}_{XY\cdot \mathbf {Z} }}{1-{\hat {\rho }}_{XY\cdot \mathbf {Z} }}}\right)}
虛無假說 是
H
0
:
ρ
X
Y
⋅
Z
=
0
{\displaystyle H_{0}:\rho _{XY\cdot \mathbf {Z} }=0}
H
A
:
ρ
X
Y
⋅
Z
≠
0
{\displaystyle H_{A}:\rho _{XY\cdot \mathbf {Z} }\neq 0}
H
0
{\displaystyle H_{0}}
N
−
|
Z
|
−
3
⋅
|
z
(
ρ
^
X
Y
⋅
Z
)
|
>
Φ
−
1
(
1
−
α
/
2
)
{\displaystyle {\sqrt {N-|\mathbf {Z} |-3}}\cdot |z({\hat {\rho }}_{XY\cdot \mathbf {Z} })|>\Phi ^{-1}(1-\alpha /2)}
其中
Φ
{\displaystyle \Phi }
均值 和單位標準差 的高斯分布 的累積分布函數 ,
α
{\displaystyle \alpha }
顯著水準 ,
N
{\displaystyle N}
樣本大小 。
半偏相關 (Semipartial correlation,或 part correlation)統計量與偏相關統計量類似;兩者都比較兩個變量在控制某些因素後的變異。然而,計算半偏相關時,第三個變量僅針對
X
{\displaystyle X}
Y
{\displaystyle Y}
[ 5]
Z
{\displaystyle Z}
半偏相關可以被視為更具有實際相關性,因為它相對於應變數(響應變量)的總變異進行了縮放。相反,它在理論上的用處較小,因為它對自變數的唯一貢獻的作用不那麼精確。
X
{\displaystyle X}
Y
{\displaystyle Y}
X
{\displaystyle X}
Y
{\displaystyle Y}
X
{\displaystyle X}
X
{\displaystyle X}
Z
{\displaystyle Z}
e
x
{\displaystyle e_{x}}
Y
{\displaystyle Y}
Z
{\displaystyle Z}
e
x
{\displaystyle e_{x}}
Z
{\displaystyle Z}
Y
{\displaystyle Y}
Z
{\displaystyle Z}
e
y
{\displaystyle e_{y}}
Y
{\displaystyle Y}
Z
{\displaystyle Z}
e
x
{\displaystyle e_{x}}
e
y
{\displaystyle e_{y}}
在時間序列 分析中,時間序列的偏自我相關函數
h
{\displaystyle h}
φ
(
h
)
=
ρ
X
0
X
h
⋅
{
X
1
,
…
,
X
h
−
1
}
{\displaystyle \varphi (h)=\rho _{X_{0}X_{h}\,\cdot \,\{X_{1},\,\dots \,,X_{h-1}\}}}
該函數用於確定自我迴歸 (AR)過程的適當滯後長度。
當樣本量小於變量數量(即高維數據設置)時,估計偏相關具有挑戰性。在這種情況下,樣本共變異數
Σ
^
{\displaystyle {\hat {\Sigma }}}
病態 的,求其逆矩陣
Ω
^
{\displaystyle {\hat {\Omega }}}
收縮估計 (Shrinkage estimation)方法可以改善
Σ
^
{\displaystyle {\hat {\Sigma }}}
Ω
^
{\displaystyle {\hat {\Omega }}}
[ 6]
Σ
^
[
λ
]
=
λ
T
+
(
1
−
λ
)
Σ
{\displaystyle {\hat {\Sigma }}^{[\lambda ]}=\lambda T+(1-\lambda )\Sigma }
其中
Σ
^
{\displaystyle {\hat {\Sigma }}}
T
{\displaystyle T}
λ
∈
(
0
,
1
)
{\displaystyle \lambda \in (0,1)}
Ledoit-Wolf 收縮下的偏相關估計為:[ 7]
P
^
i
j
[
λ
]
=
Ω
^
i
j
[
λ
]
Ω
^
i
i
[
λ
]
Ω
^
j
j
[
λ
]
{\displaystyle {\hat {P}}_{ij}^{[\lambda ]}={\frac {{\hat {\Omega }}_{ij}^{[\lambda ]}}{\sqrt {{\hat {\Omega }}_{ii}^{[\lambda ]}{\hat {\Omega }}_{jj}^{[\lambda ]}}}}}
其中
Ω
^
i
j
[
λ
]
{\displaystyle {\hat {\Omega }}_{ij}^{[\lambda ]}}
Σ
^
i
j
[
λ
]
{\displaystyle {\hat {\Sigma }}_{ij}^{[\lambda ]}}
^ 1.0 1.1 Baba, Kunihiro; Ritei Shibata; Masaaki Sibuya. Partial correlation and conditional correlation as measures of conditional independence. Australian and New Zealand Journal of Statistics . 2004, 46 (4): 657–664. S2CID 123130024 doi:10.1111/j.1467-842X.2004.00360.x ^ Guilford J. P., Fruchter B. Fundamental statistics in psychology and education . Tokyo: McGraw-Hill Kogakusha, LTD. 1973. ^ Kim, Seongho. ppcor: An R Package for a Fast Calculation to Semi-partial Correlation Coefficients . Communications for Statistical Applications and Methods. November 2015, 22 (6): 665–674. ISSN 2287-7843 PMC 4681537 PMID 26688802 doi:10.5351/CSAM.2015.22.6.665 ^ Rummel, R. J. Understanding Correlation . 1976 [2026-01-22 ] . (原始內容存檔 於2025-01-10). ^ Partial and Semipartial Correlation . (原始內容 存檔於2014-02-06). ^ Ledoit, O., & Wolf, M. (2004). "A well-conditioned estimator for large-dimensional covariance matrices". Journal of Multivariate Analysis , 88(2), 365–411. https://doi.org/10.1016/S0047-259X(03)00096-4
^ Schäfer, J., & Strimmer, K. (2005). "A shrinkage approach to large-scale covariance matrix estimation and implications for functional genomics". Statistical applications in genetics and molecular biology , 4(1). https://doi.org/10.2202/1544-6115.1175


 提示:此條目的主題不是部分決定係數 (Coefficient of partial determination)。


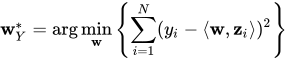


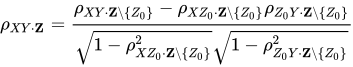

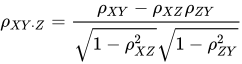


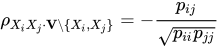


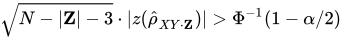


 . PMID 26688802. doi:10.5351/CSAM.2015.22.6.665.


